テキスト抽出

ページ上のすべてのテキストを、読み取って渡す。

1話分をドロップするだけ。tinypicaが吹き出し、効果音、ナレーションをすべて検出し、順番に読み取って、台本をテキストファイルで渡します。翻訳はしません。絵にも一切手を加えません。

登録で1,000クレジット · カード不要
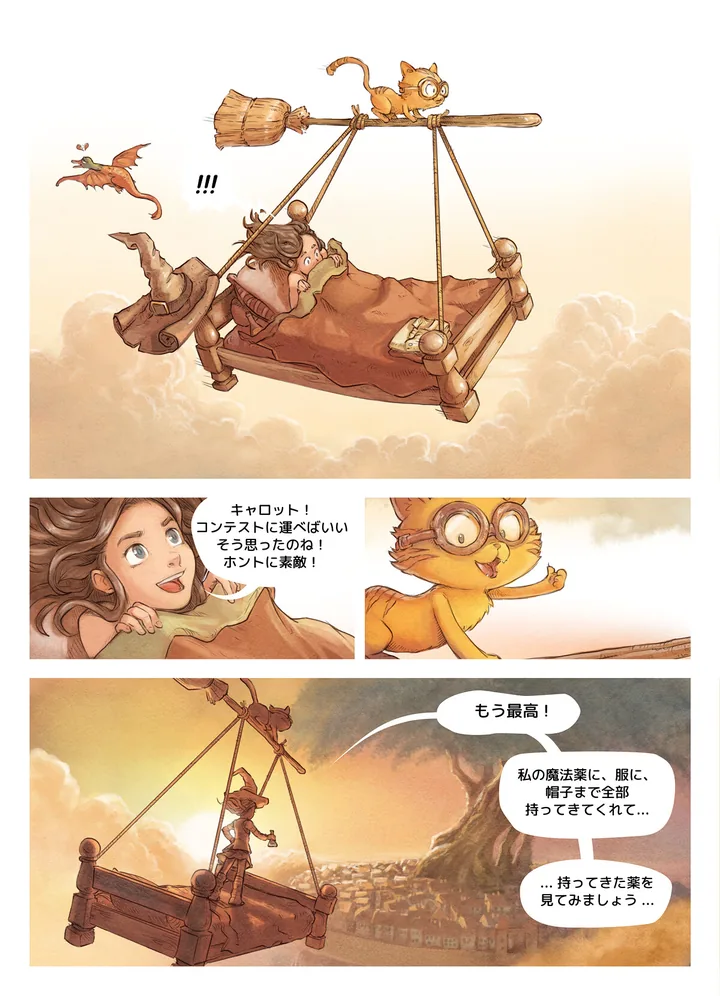
吹き出しと効果音がすべて枠で囲まれた日本語のマンガのページR-01R-02R-03R-04R-05

5件のテキストを検出 · chapter-1-source.txt

  1. R-01!!!
  2. R-02.キャロット!コンテストに運べばいいそう思ったのね!ホントに素敵!
  3. R-03もう最高!
  4. R-04私の魔法薬に、服に、帽子まで全部持ってきてくれて...
  5. R-05...持ってきた薬を見てみましょう...

吹き出し · 効果音 · ナレーション、読み順で

アップロードしたままのページと、そこで検出されたすべてのテキスト領域 · デモページ:David Revoy作「Pepper & Carrot」、CC BY 4.0。tinypicaによる改変:読み取り、翻訳、写植のやり直し。

料金

4クレジット / ページ

どのAIモデルでも同じ料金です。

手に入るもの

Source TXT

読み取ったままの台本を、1話につき1ファイル。 書き出しは無料。

対応する原稿

どの言語でも

原稿は日本語、韓国語、中国語、そのほか何語でもかまいません。元言語のリストはありません。


苦手なところ

判断できるように、ありのままを。

まだベータ版です。どのテキストもあとから編集できるので、見落としがあっても作業が止まることはなく、すぐに直せます。

  • 絵に重ねて描き込まれた密度の高い効果音は、今もときどき見落とします。
  • 手書きや装飾の強い文字は、印刷書体より読み取りの精度が落ちます。
  • 読み順はページに従うため、変則的なコマ割りでは順番が入れ替わることがあります。

よくある質問

最初に聞かれること。

どの言語を読み取れますか?
どの言語でも読み取れます。言語を選ぶリストはなく、日本語、韓国語、中国語、英語、そのほか何語のページでも、そのまま読み取ります。
縦に長いウェブトゥーンの原稿にも使えますか?
はい。縦長原稿の1話は、いくつのファイルに分かれていても1本の原稿として読み込まれ、コマとコマの間の余白でページに分割されます。2つのファイルにまたがって切れていた吹き出しも、読み取る前に1つにつながります。
最後に何が手に入りますか?
その話の台本が、プレーンテキストのファイルで手に入ります。すべてのテキストが読み順に並んでいます。同じテキストはエディターでページの上にも表示され、読み間違いがあれば手で直せます。
どうやって読み順を判断していますか?
プロジェクトを作るときに選ぶ読む方向から判断します。マンガなら右から左、コミックなら左から右、縦長原稿なら上から下です。台本もその順番に従います。

まずは1ページ、無料で。

登録すると1,000クレジット。カードは不要です。プロジェクトを作るときに「Text only」を選んでください。